NoBanのTwitterイラスト検索結果。 925 件中 2ページ目


最近の画像生成モデルたち
ちょっと複雑なプロンプトで
Z-Imageとnanobanana proとflux2が難なくクリア
Z-Imageが
5090で9step,1024×で3.78s
ランダム性なくて爆速
もう少し複雑でも行ける。
派生系が楽しみなモデル。


Grok, ChatGPT, Gemini(NanoBananaPro) に改善案を質問してみた。
ChatGPTは説明が丁寧で、Geminiは余計な改善案をよこしてくる。またいずれも画像生成だと線路方向の一点透視図な絵を用意してきて、こちらの意図を汲み取ってくれない。けどこれはそう描くオタクや似た写真の多さからか…人間が悪い。 https://t.co/QvhcuIr1we


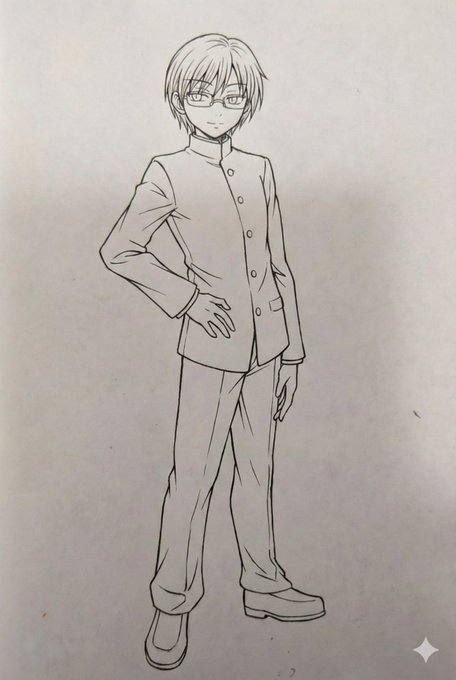


私「NanoBananaProならこのヘロヘロのラフもどうにかしてくれるんじゃないすか」
Gemini「うす」
私「指が4本である事以外は学ラン姿ほぼ完璧で笑う。ところで彼の衣装差分の衣装が思い出せないんだけど」
Gemini「それは知らねぇよ……」

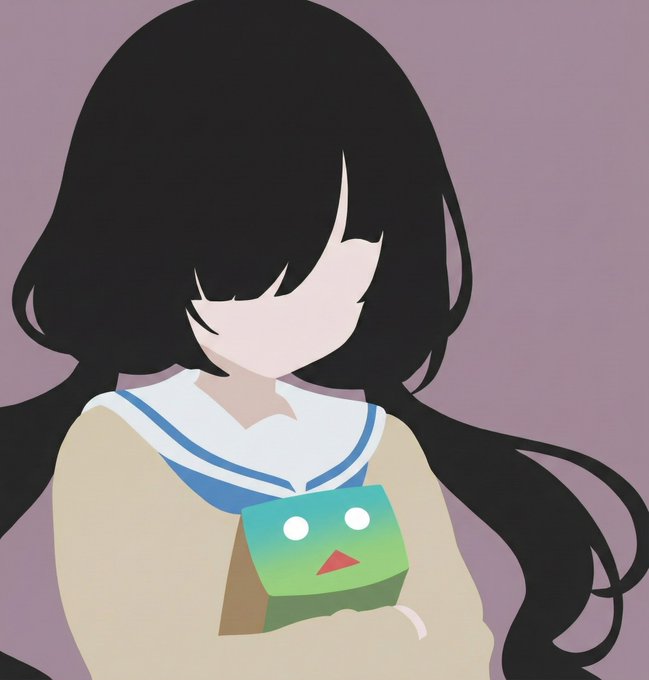

nanobanana proもベタ塗りできてるように見えて、解析かけてみると全然ベタ塗りじゃない(すごく近い色だけどRGB値が微妙に異なってる)んだよな
これが解決されないと一生正確なマスク画像が作れなくてレイヤー分け処理が上手くいかない
(近似色の統合処理を挟むとどうしても精度劣化する)


nanobanana pro、試してみたけど凄いなぁ
指示次第でちゃんとキャラと衣装を個別に認識してくれる上に、ざっくりしたお題にも応えてくれる
ユウキAォI nanobanana pro SAO https://t.co/r30Xct9MJX


nanobanana背景透過できない問題、雑に解決するならこの辺かなぁ
nanobananaでアルファ値の代わりに透過したいところをグレスケ画像として生成して、元画像のアルファ値に生成結果を挿入すれば透過画像にできる
(なお本体である抹茶もなかは消えた)


